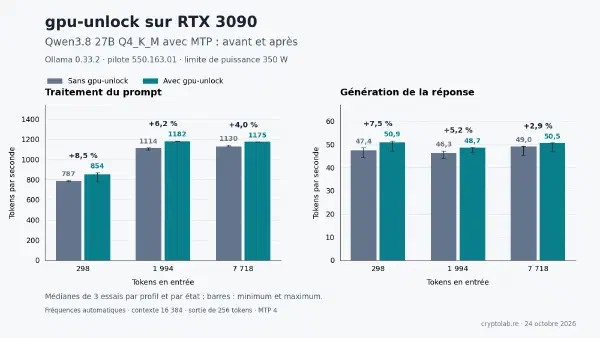
gpu-unlock déverrouille certaines capacités de calcul des GeForce RTX 3000 sous Linux. L’objectif ici : faire tourner l’IA locale plus vite avec la carte déjà installée dans le serveur. Dix-huit essais avec Qwen3.8 27B sur une RTX 3090 comparent les performances dans Ollama avant et après activation.
J’utilise des LLMs comme assistants de code depuis début 2026. D’abord avec des API cloud, puis en local.
Ce qui a changé avec une RTX 3090, c’est la bascule vers un modèle de travail où la latence et la confidentialité deviennent moins pénalisantes. L’inférence locale devient crédible pour du code à partir de 24 Go VRAM.
Voici mon setup, les chiffres réels et ce qui tient vraiment la route.