OpenCode 2.0 permet de déléguer une relecture ou une commande longue en arrière-plan, de composer ses outils MCP en JavaScript et de piloter ses propres sessions par API. L’agent de développement open source généralise aussi le service local automatique et stabilise les plugins du terminal. Pour les utilisateurs, ces changements facilitent le travail en parallèle et l’intégration de l’agent dans leurs propres workflows.
Des tâches qui continuent en arrière-plan#
Une relecture, des tests et une mise à jour de documentation n’ont pas toujours besoin de s’attendre. La 2.0 intègre les sous-agents et les commandes shell en arrière-plan : l’agent principal peut déléguer une tâche, poursuivre son travail, puis recevoir une notification quand le résultat est prêt. C’est l’un des changements mis en avant dans l’annonce officielle d’Anomaly.
Un sous-agent dispose de son propre contexte et peut utiliser un modèle différent. On peut donc lui confier une recherche ou une relecture ciblée pendant que la session principale avance. Les définitions d’agents permettent de choisir son modèle, ses instructions et ses permissions.
Exemple de demande à l’agent :
Lance un sous-agent en arrière-plan pour relire les changements et relever les régressions possibles. Pendant ce temps, mets à jour la documentation de la configuration.Le shell peut lui aussi rendre la main immédiatement et signaler la fin d’une commande. Dans le terminal, Ctrl+B permet de déplacer une commande shell ou un sous-agent déjà lancé vers l’arrière-plan. L’intérêt est particulièrement clair avec une compilation ou une suite de tests : la conversation reste disponible pendant leur exécution. Outils, raccourcis du terminal.
Code Mode devient le mode par défaut pour les outils MCP#
MCP (Model Context Protocol) permet de fournir à l’agent des outils et des ressources issus d’autres services. Code Mode était déjà présent parmi les options expérimentales de la v1. En 2.0, les serveurs MCP l’utilisent par défaut. L’agent peut écrire un petit programme JavaScript qui enchaîne les appels d’outils, traite leurs résultats et lance les opérations indépendantes en parallèle. Documentation de Code Mode.
Avec des connecteurs déjà configurés, un même script peut par exemple récupérer des tickets, ne retenir que ceux portant une étiquette précise, puis préparer des actions dans un autre service. Le filtrage s’effectue dans le script ; seuls les résultats utiles ont besoin de revenir dans le contexte du modèle. Pour les installations avec plusieurs MCP, c’est une façon de limiter l’accumulation de résultats intermédiaires.
L’interpréteur n’a pas d’accès direct au système de fichiers et ne charge pas de modules JavaScript. Les outils natifs et MCP appelés continuent d’appliquer leurs permissions. Un serveur MCP peut retrouver une exposition directe de ses outils avec codemode: false dans sa configuration. Configuration MCP.
L’agent peut organiser ses propres sessions#
L’API a été réécrite et OpenCode sait s’en servir pour gérer son travail. L’annonce montre notamment la création d’un worktree Git, le déplacement d’une session dans ce répertoire et le pilotage d’autres sessions.
Un worktree fournit un répertoire de travail distinct pour le même dépôt Git. C’est utile pour démarrer une tâche séparée sans mélanger ses fichiers avec ceux du chantier en cours. La v2 expose des outils pour créer et lister ces espaces, renommer une session et la déplacer. Outils de sessions et de worktrees.
Exemple de demande :
Crée un worktree pour travailler sur les délais d’attente HTTP, déplace cette session dedans et renomme-la « Délais HTTP ».Cette API sert aussi aux automatisations maison. Le paquet @opencode/client fournit un client TypeScript dont les méthodes et les types proviennent du même contrat que l’API serveur. Un script peut découvrir le service local et l’utiliser ; Service.ensure() le démarre si nécessaire. Pour un job planifié ou un outil interne, cela donne un point d’entrée documenté pour créer une session et lui soumettre du travail. Client JavaScript.
Un service local démarré et partagé automatiquement#
Le modèle client/serveur existait déjà en v1. Avec la 2.0, un processus partagé démarre automatiquement pour le compte utilisateur et les clients locaux s’y connectent : terminal, interface web et application de bureau utilisent le même service. Celui-ci centralise les sessions, la configuration, les intégrations et l’exécution des outils. Fonctionnement de la CLI.
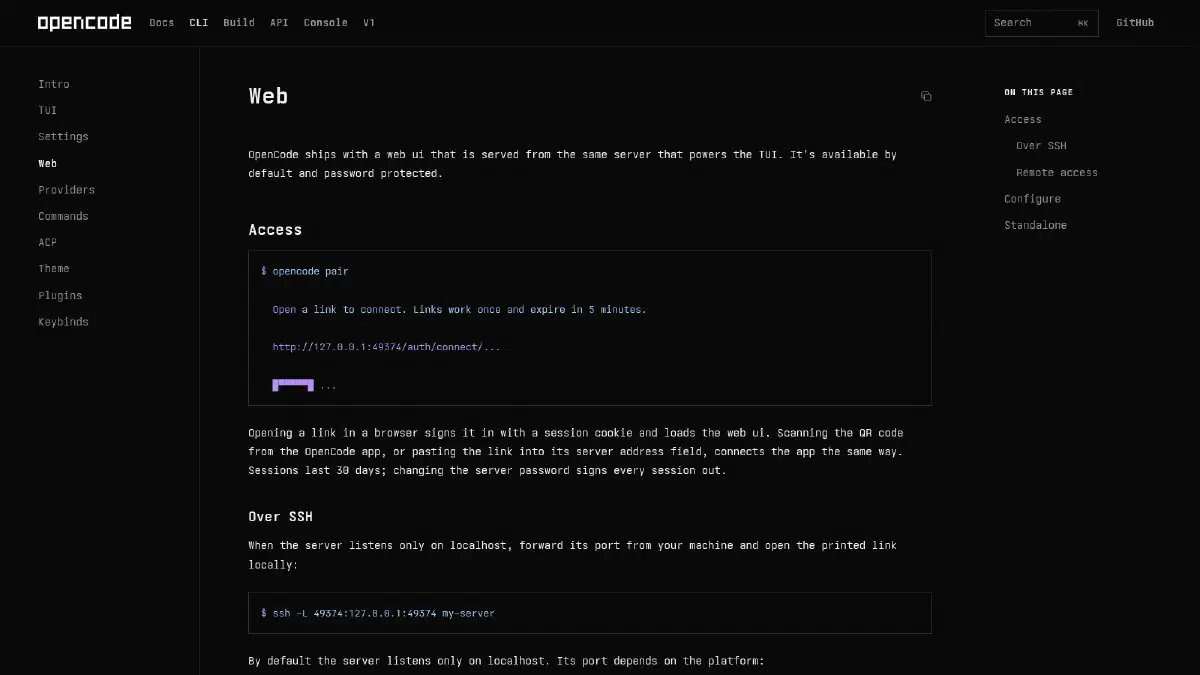
Pour une installation sur serveur, cela facilite l’accès au même environnement depuis plusieurs interfaces. Pour connecter un navigateur en accès local, exécuter sur la machine qui héberge le service :
opencode pairLa commande affiche des liens d’appairage à usage unique, valables cinq minutes. Ouvrir un lien connecte le navigateur au service. Pour un serveur distant, la documentation décrit l’accès par tunnel SSH. Accès web.
Des plugins stables pour étendre le terminal#
Anomaly annonce avoir construit l’essentiel des fonctions de la 2.0 sous forme de plugins internes, avec plus de 80 plugins. Les extensions du terminal passent aussi du statut expérimental au statut stable. L’extension devient ainsi une partie centrale de l’architecture du projet.
Ces plugins peuvent ajouter des commandes, des vues, des notifications ou des éléments d’interface. On peut par exemple construire une vue adaptée à un workflow d’équipe et la relier à l’API du serveur, y compris lorsque celui-ci est distant. La documentation des plugins du terminal détaille les points d’extension disponibles.
Autre apport pratique : les changements dans les répertoires de configuration surveillés déclenchent un rechargement automatique. Un plugin local peut donc être modifié et repris pendant la session. Les dépendances locales hors des chemins surveillés peuvent encore demander un redémarrage. Gestion et rechargement des plugins.
Cela rend crédible un usage décrit dans l’annonce : demander à OpenCode d’écrire une extension pour son propre environnement, puis l’utiliser immédiatement. Les plugins v1 doivent toutefois être portés vers la nouvelle API.
Un moteur embarquable dans ses propres applications#
La 2.0 fournit également @opencode/sdk pour héberger le moteur directement dans une application. Le SDK assemble le serveur et fait passer les appels dans son routeur HTTP en mémoire, sans ouvrir de port ni ajouter de trajet réseau entre client et serveur. SDK embarqué.
Les deux paquets répondent à des usages différents :
| Paquet | Usage |
|---|---|
@opencode/client | Piloter un serveur OpenCode existant à travers son API réseau. |
@opencode/sdk | Faire fonctionner OpenCode à l’intérieur de sa propre application. |
Pour un développeur d’outils internes, cela ouvre la possibilité d’intégrer le moteur et ses plugins à un service spécialisé, avec une interface adaptée à son usage. La documentation décrit aussi un hébergement dans les Durable Objects de Cloudflare. Anomaly précise que ce SDK reste en évolution.
Le passage en 2.0 sur mon installation#
La migration reste un point à préparer : les plugins v1 et les clients de l’ancienne API doivent être adaptés, et les préférences du terminal passent dans ~/.config/opencode/cli.json. La configuration v1 prise en charge peut rester en place. La v2 conserve aussi les réglages lsp, mais n’exécute pas les serveurs de langage : les workflows qui en dépendent doivent utiliser les commandes de lint, de vérification de types ou de compilation du projet. Guide de migration.
Dans mon installation, OpenCode 2.0.32 remplace la 1.18.25. La configuration et les 114 sessions ont été conservées, une sauvegarde a été effectuée et le service web fonctionne toujours sur le port 4096. Le détail des usages précédents reste dans les articles sur OpenCode avec Ollama et l’intégration de Firecrawl.
Sources#
- Anomaly : annonce d’OpenCode 2.0
- Agents et sous-agents
- Outils, tâches en arrière-plan et Code Mode
- Raccourcis du terminal
- Options expérimentales de la v1.18.25
- Interpréteur Code Mode de la v2
- Configuration des serveurs MCP
- Client JavaScript
- CLI et service partagé
- Interface web et appairage
- Plugins du terminal
- Gestion et rechargement des plugins
- SDK embarqué
- Migration depuis la v1