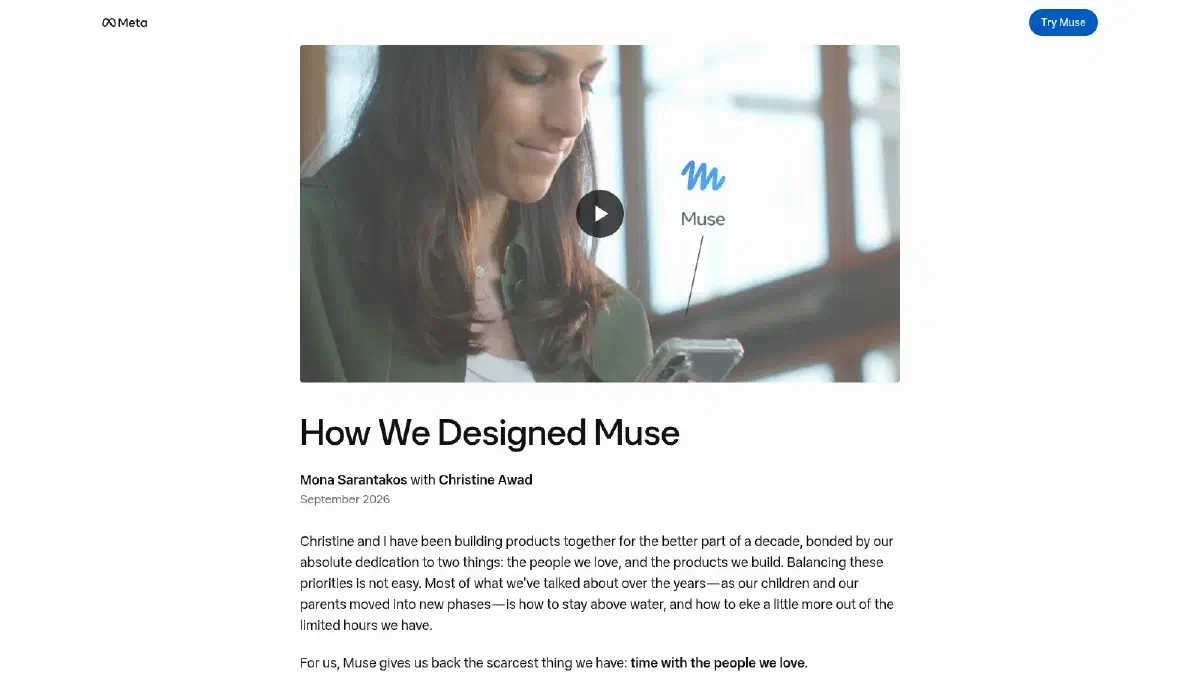
Meta présente Muse comme un assistant capable de réserver un restaurant, de préparer un voyage ou de s’occuper des mails. Moi, je me suis arrêté sur un autre détail : il a sa propre machine Linux. Avec un terminal, un navigateur et de la place pour ses fichiers.
Les premiers utilisateurs parlent de 2 vCPU, 8 Go de RAM et 100 Go de disque, y compris avec l’offre gratuite. Forcément, j’ai déjà quelques idées de scripts à lui confier. Le restaurant attendra : d’abord, un df -h.
Lancé le 8 septembre 2026, Muse n’est pas encore officiellement disponible en Europe au moment où j’écris ces lignes. Je n’ai donc pas pu le prendre en main. Mais la documentation et les retours d’utilisateurs donnent déjà de quoi s’intéresser à ce qui tourne derrière la fenêtre de discussion.
Voir Muse en action : la démonstration officielle sur YouTube.
En bref#
- Muse dispose d’un environnement Linux pour exécuter du code, manipuler des fichiers et naviguer sur le web.
- La configuration rapportée est de 2 vCPU, environ 8 Go de RAM et 100 Go de stockage utilisateur.
- Il peut poursuivre des tâches en arrière-plan et les reprendre selon un calendrier ou des événements.
- Meta propose une offre gratuite et des abonnements. Le déploiement officiel reste limité aux États-Unis au 21 septembre 2026.
2 vCPU, 8 Go de RAM et de quoi garder ses fichiers#
Sur Reddit, un utilisateur décrit deux cœurs, environ 8 Go de RAM et aucun GPU. Un retour d’inspection publié sur NodeLoc précise l’organisation du stockage :
| Ressource | Configuration rapportée |
|---|---|
| CPU | 2 vCPU |
| Mémoire | Environ 8 Go, dont 7,7 Go visibles dans ce relevé |
| Espace de travail | 100 Go dans /home/hatch |
| Racine du système | Environ 7,5 Go sur / |
Ces chiffres viennent des premiers retours utilisateurs ; Meta ne publie pas de configuration garantie.
Le détail intéressant, ce sont les deux espaces de stockage. Le témoignage décrit une petite racine pour le système et un volume séparé pour le répertoire utilisateur. Cela pourrait expliquer pourquoi on voit circuler à la fois « 7,5 Go » et « 100 Go ». Pour les scripts, les fichiers téléchargés et les résultats à conserver, c’est surtout ce deuxième espace qui m’intéresse.
Autre distinction utile : ces ressources servent à exécuter les outils de l’agent. L’inférence du modèle passe par une infrastructure externe à la VM. Les 8 Go de RAM ne servent donc pas à faire tourner tout Muse Spark localement.
Une VM par utilisateur : que fait-elle quand on ne lui parle plus ?#
Dans son analyse du 21 septembre, Dylan (@demian_ai) pose une question intéressante : combien de ces machines doivent réellement rester actives ? Avec 100 millions de comptes et 8 Go de RAM réservés en permanence pour chacun, on arrive à 800 pétaoctets de mémoire. C’est un scénario pour illustrer l’échelle, pas un chiffre annoncé par Meta.
Conserver les fichiers n’oblige pourtant pas à garder toute cette mémoire occupée. En virtualisation, on peut sauvegarder l’état d’une machine sur disque, l’arrêter, puis la restaurer à la demande. Une simple pause, elle, conserve généralement la RAM. La documentation libvirt explique cette différence ; elle ne décrit pas l’implémentation de Muse.
Pour ma veille du lundi, cela pose des questions très concrètes : le délai de réveil, la reprise d’un travail interrompu et le déclenchement des tâches à l’heure prévue. Un cron dans une VM arrêtée ne va pas la rallumer tout seul. Le service doit organiser ce réveil à l’extérieur de la machine.
Voilà un comportement que j’ai envie d’observer : retrouver mon environnement après quelques jours sans y toucher, puis voir comment il reprend le travail.
Un agent qui retrouve son travail le lendemain#
La présentation de l’équipe produit décrit un agent capable d’écrire du code, de l’exécuter et de produire des documents ou des pages web. Il dispose de fichiers et d’une mémoire entre les échanges, et peut travailler après la fermeture de l’application.
C’est cette continuité qui me donne envie d’essayer : produire un relevé, le conserver et le comparer au suivant. Le navigateur sert à récupérer l’information, le code à la traiter et les fichiers à garder le résultat.
Mes premiers candidats : la veille et les petites corvées de fichiers#
Pour le blog, je commencerais par le suivi des versions de quelques projets. La consigne pourrait ressembler à ceci :
Chaque lundi, consulte les nouvelles versions des projets de cette liste. Compare-les au relevé précédent, conserve les liens vers les annonces officielles et prépare un fichier Markdown avec les changements qui demandent une action : migration, option supprimée ou modification de configuration. Prépare un brouillon, je m’occupe de la publication.
Ce serait un bon premier essai : les sources sont publiques, le résultat se vérifie facilement et les fichiers de la semaine précédente ont une vraie utilité. Pour un article sur une vulnérabilité, je continuerais évidemment à relire l’advisory et les versions concernées moi-même.
J’ai aussi quelques autres tâches en tête :
- Nettoyer des exports CSV : harmoniser les dates, dédoublonner les lignes et sortir un fichier exploitable.
- Comparer deux inventaires du homelab : relever les services ajoutés, les versions modifiées et les différences de configuration à examiner.
- Préparer un petit rapport HTML à partir de données publiques, avec les liens et les fichiers qui ont servi à le construire.
Rien de spectaculaire. Juste le genre de petites tâches qui commence par « j’en ai pour cinq minutes » et finit par occuper le dimanche après-midi.
Le premier tour du propriétaire#
Si vous avez déjà accès à Muse, vous pouvez lui demander d’exécuter ces commandes et d’afficher les sorties. Elles sont en lecture seule et ne nécessitent pas sudo :
# CPU et mémoire visibles depuis l'environnement d'exécution
nproc
lscpu
free -h

# Comparer le système de fichiers racine et celui du répertoire utilisateur
df -hT / "$HOME"
findmnt -T /
findmnt -T "$HOME"
nproc donne les unités de traitement disponibles au processus. df et findmnt permettent surtout de voir si / et le répertoire utilisateur correspondent à deux montages différents. Si $HOME pointe ailleurs, examinez aussi /home/hatch s’il existe.
Ensuite, je laisserai un fichier dans l’espace de travail et je reviendrai le chercher quelques jours plus tard, avec une nouvelle tâche qui le réutilise. C’est exactement le comportement dont j’ai besoin pour mon relevé de versions.
Pendant ces essais, je regarderai aussi la consommation affichée dans le compte. La place sur le disque et le quota d’utilisation du modèle sont deux choses différentes. Meta propose un accès gratuit pour les usages courants et des abonnements pour aller plus loin.
Les accès restent encadrés#
La documentation technique de Meta décrit un conteneur systemd-nspawn à l’intérieur de la VM. Le root de ce conteneur est associé à un utilisateur non privilégié dans la VM. Sentinel, un composant séparé, contrôle les actions des connecteurs et les sorties réseau ; les identifiants des connecteurs restent hors de portée directe de l’agent.
Pour ma veille, des pages publiques suffiront. Si j’ajoute ensuite un connecteur, le journal d’activité me permettra de suivre les actions effectuées.
Il reste un réglage à connaître avant d’importer ses documents : les interactions peuvent servir à l’entraînement, avec une option pour s’y opposer. Meta conserve aussi la possibilité d’accéder aux données pour exploiter ou sécuriser le service. La variante Confidential VM est annoncée pour plus tard en 2026.
Conclusion : vivement le test européen#
J’ai hâte de tester Muse dès qu’il sera officiellement disponible en Europe. Au 21 septembre, l’annonce Meta ne donne pas de calendrier pour cette ouverture.
Il ne manque plus que l’accès. Pour une fois, j’ai préparé les tâches avant de provisionner la machine.
Sources#
- Meta : annonce de Muse, disponibilité et offre gratuite, 8 septembre 2026.
- Meta : architecture, isolation, permissions et traitement des données.
- Équipe Muse : conception du produit, outils et journal d’activité ; source de la capture d’écran d’illustration.
- Meta : démonstration officielle de Muse sur YouTube, référencée sur le site de l’équipe produit.
- Reddit, r/MetaAI : témoignage sur les CPU, la mémoire et l’absence de GPU, 21 septembre 2026.
- NodeLoc : retour d’inspection de la VM et de ses montages, 21 septembre 2026, témoignage non vérifié indépendamment, contenant du parrainage.
- Dylan (@demian_ai) : réflexion sur les ressources nécessaires à grande échelle, 21 septembre 2026.
- Libvirt : sauvegarde de l’état d’une VM et libération de sa mémoire.
- GNU Coreutils : documentation de nproc et de df.