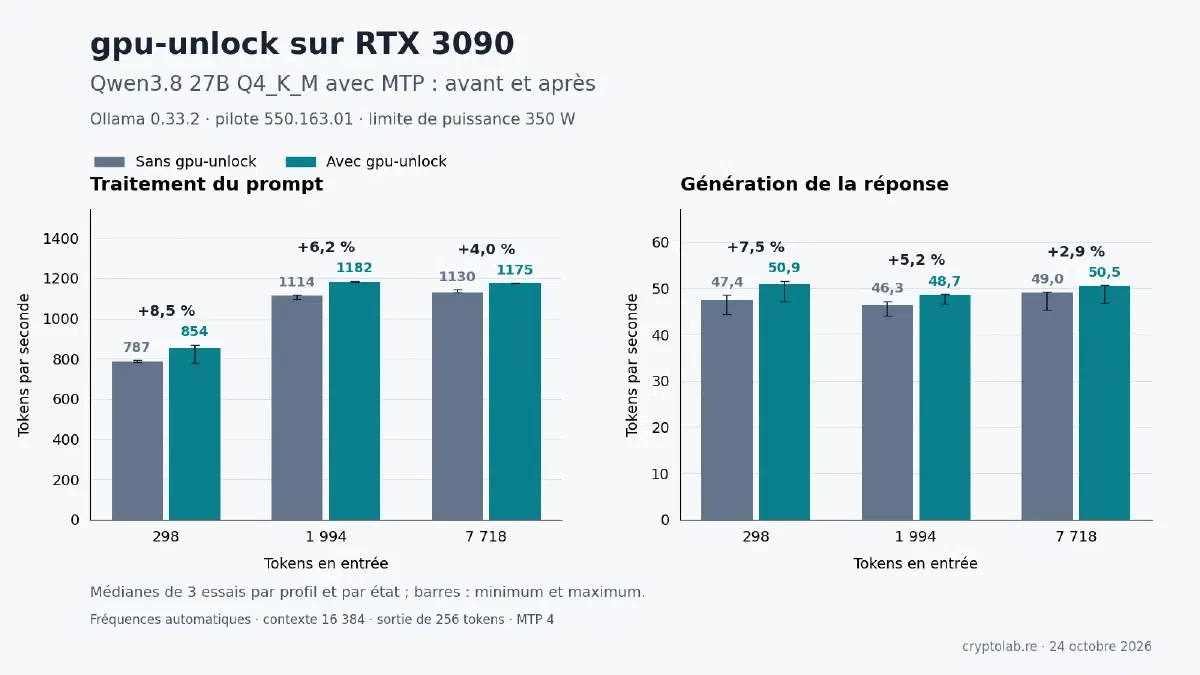
gpu-unlock déverrouille certaines capacités de calcul des GeForce RTX 3000 sous Linux. L’objectif ici : faire tourner l’IA locale plus vite avec la carte déjà installée dans le serveur. Dix-huit essais avec Qwen3.8 27B sur une RTX 3090 comparent les performances dans Ollama avant et après activation.
En bref#
- Le résultat sur ce serveur : les débits médians mesurés progressent de 4 à 8,5 % pour traiter le texte envoyé au modèle, puis de 3 à 7,5 % pour générer la réponse.
- Les cartes concernées : certaines GeForce RTX 3000. Cette version reconnaît 51 identifiants matériels ; le test présenté ici porte sur une RTX 3090 de 24 Go.
- L’installation : un module chargé au démarrage de Linux, puis un redémarrage du serveur. Le BIOS de la carte mère et celui de la carte graphique restent en place.
Pour aller directement au concret, les résultats du benchmark précèdent le guide d’installation sur Debian ou Ubuntu.
Ce que gpu-unlock débloque vraiment#
Le projet de Zagitta vise certaines instructions Tensor Core utilisées avec des entrées FP16 ou BF16 et une accumulation en FP32. Le doublement annoncé concerne leur débit d’émission. Un LLM fait aussi travailler la mémoire, l’attention et différents kernels de calcul : les tokens par seconde dépendent de l’ensemble.
Le mécanisme intervient au démarrage de Linux. Avant que le pilote NVIDIA prenne la carte, le module gpu_unlock exécute une séquence de firmware, modifie des sélecteurs internes puis réinitialise le GPU. Le pilote habituel reprend ensuite la main. Le document technique du projet détaille cette séquence.
L’installation ajoute donc un module à l’initramfs, le petit environnement Linux chargé au démarrage, et une option dans GRUB. Le BIOS de la carte mère et le VBIOS de la carte graphique restent en place. Les 24 Go de VRAM restent aussi 24 Go. On aurait pris le supplément.
Dans Ollama, il faut distinguer deux phases : le traitement du prompt, ou prefill, puis la génération de la réponse token par token. La première effectue beaucoup de calculs matriciels ; pour une requête unique, la seconde dépend souvent davantage des accès mémoire. Cette distinction est expliquée dans les travaux sur le backend CUDA de llama.cpp.
Avec Qwen3.8 en Q4_K_M, les poids sont quantifiés et le backend utilise des kernels dédiés aux modèles quantifiés. C’est donc le débit réel dans Ollama qui nous intéresse ici.
Quelles cartes sont prises en charge ?#
La révision testée, 4189b17, reconnaît 51 identifiants PCI NVIDIA, répartis entre GA102, GA103, GA104 et GA106. Le nom commercial ne suffit pas : une même référence existe parfois avec plusieurs puces. La table du module donne la liste exacte ; les noms ci-dessous proviennent de la base PCI du projet pciutils.
| Puce | Références présentes dans la liste, selon variante | État de validation |
|---|---|---|
| GA102 | RTX 3090 et 3090 Ti, RTX 3080 et 3080 Ti, une variante de RTX 3070 Ti, CMP 90HX, références OEM et prototypes | RTX 3090 10de:2204 vérifiée sur ce serveur |
| GA104 | RTX 3060, 3060 Ti, 3070 et 3070 Ti ; certaines RTX 3070, 3070 Ti et 3080 mobiles ; CMP 70HX | Essais Linux publiés sur RTX 3070 |
| GA103 | RTX 3060 Ti 10de:2414 | Explicitement marquée « untested » dans le code |
| GA106 | Certaines RTX 3060 et RTX 3050, dont des variantes OEM | Le code mentionne une validation sur RTX 3060 12 Go 10de:2504 |
Voici les 51 identifiants acceptés par cette version, avec le constructeur NVIDIA 10de :
GA102
2200 2203 2204 2205 2206 2207 2208 220a 220d 2216 222b 222f

GA104
2480 2482 2483 2484 2486 2487 2488 2489 248a 248c 248d 248e
249c 249d 249f 24a0 24a4 24ac 24ad 24af 24bf 24c0 24c7 24c8
24c9 24dc 24dd 24df 24e0

GA103
2414

GA106
2501 2503 2504 2505 2507 2508 2509 252f 2544
La liste téléchargeable associe chaque identifiant à son nom dans la base PCI, lorsqu’il y est renseigné. Elle décrit les cartes reconnues par le code. La RTX 3080 Ti 20 Go OEM 2205, par exemple, fait l’objet d’un retour matériel où les sélecteurs sont modifiés sans augmentation du débit BF16.
Les RTX 2000, RTX 4000, RTX 5000 et les puces GA107 sont absentes de cette révision. Le code exclut également les variantes mobiles GA103 et GA106, alors que plusieurs GA104 mobiles sont bien présentes.
Pour identifier sa carte sous Linux :
lspci -Dnnk -d 10de:La ligne graphique donne à la fois l’adresse PCI complète et l’identifiant matériel. Sur le serveur de ce test, ce sont 0000:01:00.0 et 10de:2204. La fonction audio HDMI apparaît sur une autre ligne.
Les résultats dans Ollama : 18 essais avant et après#
La comparaison utilise le même modèle, le même pilote et les mêmes paramètres. Chaque profil compte trois variantes de texte synthétique, reprises à l’identique dans les deux états. Chaque requête produit exactement 256 tokens.
Traitement du prompt#
| Tokens en entrée | Sans gpu-unlock | Avec gpu-unlock | Écart des médianes |
|---|---|---|---|
| 298 | 786,52 tokens/s | 853,51 tokens/s | +8,52 % |
| 1 994 | 1 113,58 tokens/s | 1 182,42 tokens/s | +6,18 % |
| 7 718 | 1 129,55 tokens/s | 1 175,14 tokens/s | +4,04 % |
Génération de la réponse#
| Tokens en entrée | Sans gpu-unlock | Avec gpu-unlock | Écart des médianes |
|---|---|---|---|
| 298 | 47,39 tokens/s | 50,93 tokens/s | +7,47 % |
| 1 994 | 46,26 tokens/s | 48,67 tokens/s | +5,23 % |
| 7 718 | 49,04 tokens/s | 50,47 tokens/s | +2,91 % |
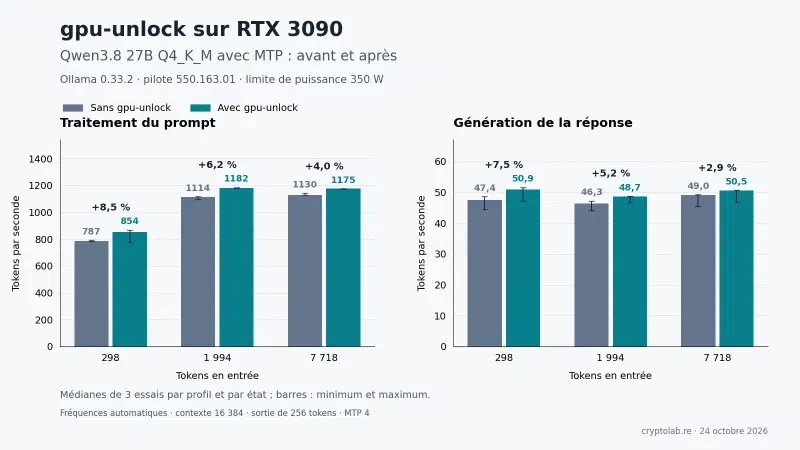
Pour le prompt de 7 718 tokens, le premier fragment de réponse arrive en médiane après 6,869 secondes avant, puis 6,607 secondes après : environ 262 ms de différence. La requête complète passe de 12,106 à 11,701 secondes, soit environ 405 ms. Pour ce modèle, les différences observées se comptent donc en quelques tokens/s et en fractions de seconde.
Les neuf paires de réponses ont les mêmes empreintes SHA-256. Le modèle reste entièrement en VRAM et l’occupation totale relevée par nvidia-smi atteint environ 18,47 Gio dans les deux séries. Le journal du noyau ne contient aucune erreur NVIDIA Xid à la fin des essais.
Les données sans déverrouillage, les données avec déverrouillage et le calcul des écarts sont disponibles avec leurs compteurs, durées et relevés GPU.
Le banc d’essai et les paramètres retenus#
Le serveur est celui de l’assistant de code local avec Ollama et opencode. La configuration relevée le 24 octobre 2026 est la suivante :
| Élément | Configuration |
|---|---|
| Système et noyau | Debian forky/sid, 6.19.10+deb14-amd64 |
| Processeur et RAM | Xeon W-1270, 8 cœurs et 16 threads, environ 62 Gio utilisables |
| GPU | RTX 3090, 24 Gio de VRAM, limite de 350 W |
| Pilote NVIDIA | 550.163.01 |
| Ollama | 0.33.2 |
| Modèle local | qwen3.8:27b, 27,3 milliards de paramètres, Q4_K_M avec MTP |
| Contexte et sortie | 16 384 tokens réservés, sortie plafonnée à 256 tokens, thinking désactivé |
Le digest du modèle installé est 22130167c4c20e20c7b71454612966ca8e8171e9b3cc8ab6ce8aa6cbfec79643. Il correspond à la variante qwen3.8:27b-mtp-q4_K_M dans le catalogue Ollama consulté le 24 octobre. Le tag public :27b avait déjà un autre digest : garder les mêmes poids est donc plus précis que garder seulement le même nom.
Le runner utilise bien --spec-type draft-mtp et --spec-draft-n-max 4. Le modèle, le template, la version d’Ollama, le noyau et les options sont identiques entre les deux séries.
La limite de puissance est fixée à 350 W, avec des fréquences gérées automatiquement par le GPU. Les relevés donnent ces conditions :
| Relevé | Sans gpu-unlock | Avec gpu-unlock |
|---|---|---|
| Température GPU pendant les essais | 59 à 75 °C | 48 à 73 °C |
| Fréquence des unités de calcul (SM), médiane | 1 470 MHz | 1 545 MHz |
| Fréquence mémoire | 9 501 MHz | 9 501 MHz |
La médiane de fréquence regroupe l’ensemble des relevés GPU. L’écart existe encore à la fin du dernier essai : les trois derniers relevés actifs donnent 1 410 puis 1 470 MHz, à 73 °C dans les deux cas. Les tableaux de débit décrivent ces deux séries avec le Boost automatique.
Remettre le cache à zéro entre les essais#
Ollama réutilise le cache des prompts. Dans le code de la version 0.33.2, le compteur des tokens d’entrée additionne ceux réutilisés et ceux nouvellement traités. Cette version ne fournit pas encore le compteur séparé prompt_eval_cached_count dans ses métriques publiques.
Le protocole décharge donc le modèle cible entre les essais, le précharge sans prompt, puis mesure sa première requête. Le chargement est séparé de la requête chronométrée. Les initialisations propres à cette première génération sont comprises dans la mesure, dans les deux états.
Les textes décrivent des services fictifs. Leur identifiant de répétition varie en début de prompt ; les neuf textes sont ensuite appariés exactement entre les séries. Aucun document ni journal privé du serveur n’entre dans le modèle pour ce test.
Les options communes sont les suivantes :
{
  "think": false,
  "options": {
    "num_ctx": 16384,
    "num_predict": 256,
    "num_batch": 512,
    "temperature": 0,
    "seed": 42
  }
}
Les autres clients Ollama sont suspendus pendant les mesures. Le script vérifie le digest, le contexte effectif, la résidence en VRAM et la limite de puissance. Les métadonnées d’exécution et la vérification du déverrouillage conservent ces éléments.
Installer gpu-unlock sur Debian ou Ubuntu#
Ce pas-à-pas concerne un hôte utilisant GRUB et initramfs-tools, avec un pilote NVIDIA déjà fonctionnel. C’est l’intégration utilisée sur ce serveur. Les commandes d’administration utilisent sudo ; depuis une session root, retirez ce préfixe.
Préparer les outils et relever l’adresse PCI#
Les headers doivent correspondre au noyau actuellement démarré. Avec un noyau fourni par la distribution :
sudo apt-get update
sudo apt-get install git build-essential python3 zstd xz-utils \
  dkms debhelper dh-sequence-dkms pciutils mokutil \
  "linux-headers-$(uname -r)"
Le paquet nécessite DKMS 3.0.11 ou plus récent. Vérifiez sa version, le pilote, l’état de Secure Boot et la carte ciblée :
nvidia-smi
dkms --version
mokutil --sb-state
lspci -Dnnk -d 10de:
Le serveur de ce test utilise Secure Boot désactivé. Avec Secure Boot actif, le module DKMS doit être signé avec une clé acceptée par le noyau ; l’enrôlement MOK est décrit dans la documentation Ubuntu.
Gardez une copie de la configuration du chargeur et de l’image du noyau utilisé avant de les modifier :
sudo install -d -m 700 /root/gpu-unlock-backup
sudo cp -a /etc/default/grub /boot/grub/grub.cfg \
  "/boot/initrd.img-$(uname -r)" /root/gpu-unlock-backup/
Construire les paquets de la version testée#
Le guide utilise la révision qui a servi aux mesures, 4189b17711bd487d9ea4a8ff0055e6d58d19d6d3 :
git clone https://github.com/Zagitta/gpu-unlock.git
cd gpu-unlock
git checkout --detach 4189b17711bd487d9ea4a8ff0055e6d58d19d6d3
make deb
Le Makefile du projet télécharge les entrées NVIDIA épinglées, vérifie leurs SHA-256 et produit les deux paquets. Le paquet CachyOS utilisé comme source de firmware est lu pendant la construction ; il ne remplace pas le pilote du système.
Installez ensuite les paquets générés :
sudo apt-get install \
  ./build/deb/gpu-unlock-dkms_1.0.0_all.deb \
  ./build/deb/gpu-unlock-firmware_1.0.0_all.deb
DKMS compile le module pour les noyaux disposant de leurs headers et les initramfs sont reconstruits. Sur ce serveur, les trois noyaux installés ont reçu leur module. Le pilote NVIDIA est resté en version 550.163.01.
Vérifier l’initramfs et l’ordre de chargement#
Le module doit intervenir avant le pilote NVIDIA. Ces commandes montrent la construction DKMS, les firmwares attendus et les fichiers présents dans l’image :
dkms status
modinfo -k "$(uname -r)" -F firmware gpu_unlock
lsinitramfs "/boot/initrd.img-$(uname -r)" |
  grep -E 'gpu_unlock|gpu-unlock/610\.43\.03|/(nvidia|nouveau)[^/]*\.ko'
Il faut retrouver gpu_unlock.ko et les cinq fichiers : booter_load_ga102.bin, gsp_boot_desc_ga102.bin, gsp_boot_ga102.bin, gsp_ga10x.bin et v67-ga102-610.43.03.bin. Le numéro 610.43.03 désigne ces entrées firmware ; le pilote installé reste une version distincte.
Si le module manque dans l’image, ajoutez-le explicitement à la liste locale et reconstruisez-la :
grep -qxF gpu_unlock /etc/initramfs-tools/modules ||
  printf '%s\n' gpu_unlock |
  sudo tee -a /etc/initramfs-tools/modules >/dev/null
sudo update-initramfs -u -k all
Ici, initramfs-tools 0.150 lit le fichier modules.d fourni par le paquet et ajoute gpu_unlock à /conf/modules. Aucun pilote graphique NVIDIA ou Nouveau n’est inclus dans l’image : le module de déverrouillage termine donc son travail avant le chargement du pilote depuis le système principal. Les vérifications de cette préparation sont disponibles.
Si l’image contient déjà nvidia.ko ou nouveau.ko, faites charger gpu_unlock avant la découverte des périphériques par udev. Le script utilisé dans l’issue 11 se place dans init-top :
sudo install -d -m 755 /etc/initramfs-tools/scripts/init-top
sudo tee /etc/initramfs-tools/scripts/init-top/gpu-unlock >/dev/null <<'EOF'
#!/bin/sh
PREREQ=""
prereqs() { echo "$PREREQ"; }
case "$1" in
  prereqs) prereqs; exit 0 ;;
esac
modprobe gpu_unlock
exit 0
EOF
sudo chmod 755 /etc/initramfs-tools/scripts/init-top/gpu-unlock
sudo update-initramfs -u -k all
Contrôlez ensuite l’ordre dans l’image reconstruite, en l’extrayant dans un répertoire temporaire :
gpu_unlock_check_dir="$(mktemp -d)"
sudo unmkinitramfs "/boot/initrd.img-$(uname -r)" "$gpu_unlock_check_dir"
sudo find "$gpu_unlock_check_dir" -type f -path '*/scripts/init-top/ORDER' \
  -exec grep -nE 'gpu-unlock|/udev' {} +
sudo rm -rf -- "$gpu_unlock_check_dir"
La ligne gpu-unlock doit apparaître avant udev. Cette lecture contrôle l’image utilisée au prochain démarrage, selon les règles d’initramfs-tools.
Activer le module pour la carte choisie#
Remplacez 0000:01:00.0 par l’adresse complète de votre GPU obtenue avec lspci -D. L’option est isolée dans un fichier dédié, ce qui conserve le contenu de /etc/default/grub :
sudo install -d -m 755 /etc/default/grub.d
sudo tee /etc/default/grub.d/90-gpu-unlock.cfg >/dev/null <<'EOF'
GRUB_CMDLINE_LINUX_DEFAULT="${GRUB_CMDLINE_LINUX_DEFAULT:-} gpu_unlock.targets=0000:01:00.0"
EOF
sudo update-grub
Cette configuration cible une seule carte. La valeur all proposée par le projet sélectionne toutes les cartes dont l’identifiant figure dans sa table.
L’activation intervient au redémarrage du serveur :
sudo systemctl rebootSur le banc d’essai, ce redémarrage logiciel a suffi. Le journal a enregistré le déverrouillage de la 3090, puis le pilote NVIDIA a repris la carte.
Vérifier que le déverrouillage a fonctionné#
Après le retour du serveur, adaptez à nouveau l’adresse PCI si nécessaire :
cat /proc/cmdline
sudo journalctl -k -b --no-pager | grep -F gpu_unlock
lspci -Dnnk -s 0000:01:00.0
nvidia-smi
ollama ps
Le message recherché est le suivant, capturé sur le serveur :
pci 0000:01:00.0: gpu_unlock: unlockedlspci doit ensuite indiquer Kernel driver in use: nvidia. Le paramètre dans /proc/cmdline confirme l’activation demandée ; le message unlocked confirme l’exécution du déverrouillage.
| Message ou résultat | Action correspondante |
|---|---|
unlock failed (-16) ou -EBUSY | Faire charger gpu_unlock avant le pilote NVIDIA dans l’initramfs |
card already initialised since power on | Effectuer un arrêt complet puis un rallumage pour réinitialiser l’état de la carte |
| Module refusé avec Secure Boot actif | Signer le module et enrôler la clé MOK selon la distribution |
Option gpu_unlock.targets absente de /proc/cmdline | Vérifier l’entrée du chargeur effectivement démarrée |
Le compte rendu du démarrage utilisé pour le test contient le message unlocked, les contrôles du runner MTP et l’état des services après les mesures.
Refaire le benchmark sur son serveur#
Le script Python utilisé pour les essais fonctionne avec la bibliothèque standard et nvidia-smi, sur l’hôte du GPU. Le modèle doit déjà être installé dans Ollama. Les autres clients restent suspendus pendant la série ; deux requêtes simultanées sur le même modèle ne sont pas distinguées par un simple relevé des modèles chargés.
Téléchargez bench-ollama.py dans votre répertoire de travail :
curl -fsSL -o bench-ollama.py \
  https://cryptolab.re/posts/2026/gpu-unlock-rtx-3090-ollama-qwen38/bench-ollama.py
Lancez ensuite la série sans déverrouillage :
python3 bench-ollama.py \
  --model qwen3.8:27b \
  --label stock \
  --repeats 3 \
  --context 16384 \
  --predict 256 \
  --output stock.json
Après vérification du déverrouillage, reprenez la même commande avec --label unlocked et --output unlocked.json. Les poids, le template, les options et les textes d’entrée restent identiques entre les deux séries. Le fichier de sortie conserve chaque essai et les médianes ; un fichier existant n’est pas écrasé.
Le débit de génération est calculé avec eval_count × 10^9 / eval_duration, les durées étant exprimées en nanosecondes dans l’API Ollama. Le délai jusqu’au premier fragment est chronométré côté client sur le flux HTTP. La sortie est plafonnée à 256 tokens pour mesurer le débit, et non pour noter la qualité d’une analyse terminée.
Le graphique peut être régénéré avec son script, qui utilise matplotlib, à partir des deux JSON.
Retirer l’activation#
Pour revenir à un démarrage sans demande de déverrouillage, retirez le fichier GRUB créé dans ce guide, puis régénérez le menu :
sudo rm /etc/default/grub.d/90-gpu-unlock.cfg
sudo update-grub
Dans l’éditeur GRUB, supprimer gpu_unlock.targets=... de la ligne linux produit le même effet pour un seul démarrage. Sans cible, le module n’exécute pas de transaction.
Un arrêt complet avec coupure d’alimentation efface les sélecteurs volatils appliqués au GPU. Pour désinstaller également les deux paquets :
sudo apt-get remove gpu-unlock-dkms gpu-unlock-firmwareLa suppression du paquet DKMS reconstruit les initramfs. Si vous avez ajouté un script init-top pour votre configuration, retirez-le également et reconstruisez les images avec sudo update-initramfs -u -k all.
Sources#
- Mesures sans gpu-unlock, mesures avec gpu-unlock et comparaison calculée.
- Contexte du benchmark, préparation de l’installation et vérifications après redémarrage.
- Script du benchmark, script du graphique et liste des identifiants PCI.
- gpu-unlock : README de la révision testée et description technique du mécanisme.
- gpu-unlock : identifiants reconnus par le module et Makefile de construction des paquets.
- pciutils : base des noms et identifiants PCI.
- RTX 3070 sous Ubuntu : compte rendu matériel.
- RTX 3080 Ti 20 Go OEM : sélecteurs modifiés sans gain BF16.
- gpu-unlock : ordre de chargement avec NVIDIA dans l’initramfs.
- Debian : manuel d’initramfs-tools.
- Ubuntu : Secure Boot et modules du noyau.
- Ollama : catalogue Qwen3.8 et API de génération.
- Ollama 0.33.2 : cache des prompts et métriques de l’API.
- llama.cpp : génération et traitement des prompts sur CUDA et kernels CUDA pour les modèles quantifiés.